恒盾C#混淆加密大师新增防AI逆向:让程序里塞满干扰信息
以前要分析一个 C# 程序,分析者得会反编译、会看 IL、会在调试器里一步步跟。现在这一步被大幅简化了:把反编译出来的代码丢给 AI,问一句“这个程序的授权校验在哪里”,几分钟就能拿到一份看起来很像那么回事的结论。
也就是说,C# 程序的对手不再只是“懂逆向的人”,还包括“会用 AI 的人”。恒盾C#混淆加密大师近期新增的防AI逆向选项,就是针对这类分析方式设计的。
防AI逆向解决的是什么问题
传统的代码保护,主要在和“人”较劲:让人看不懂、让工具打不开、让调试跟不下去。
但 AI 参与之后,分析者的工作方式变了。他不需要完全读懂代码,只需要把大量代码一次性交给 AI,让 AI 去挑出“值得看”的部分。这种方式对代码的“乱”并不敏感——越乱,无非是多贴几次。
防AI逆向针对的正是这一点:它不追求让程序变成一团无法阅读的乱码,而是让整个程序里充满大量没有价值的干扰信息,把真正有用的代码稀释掉。
勾选之后,程序里多了什么
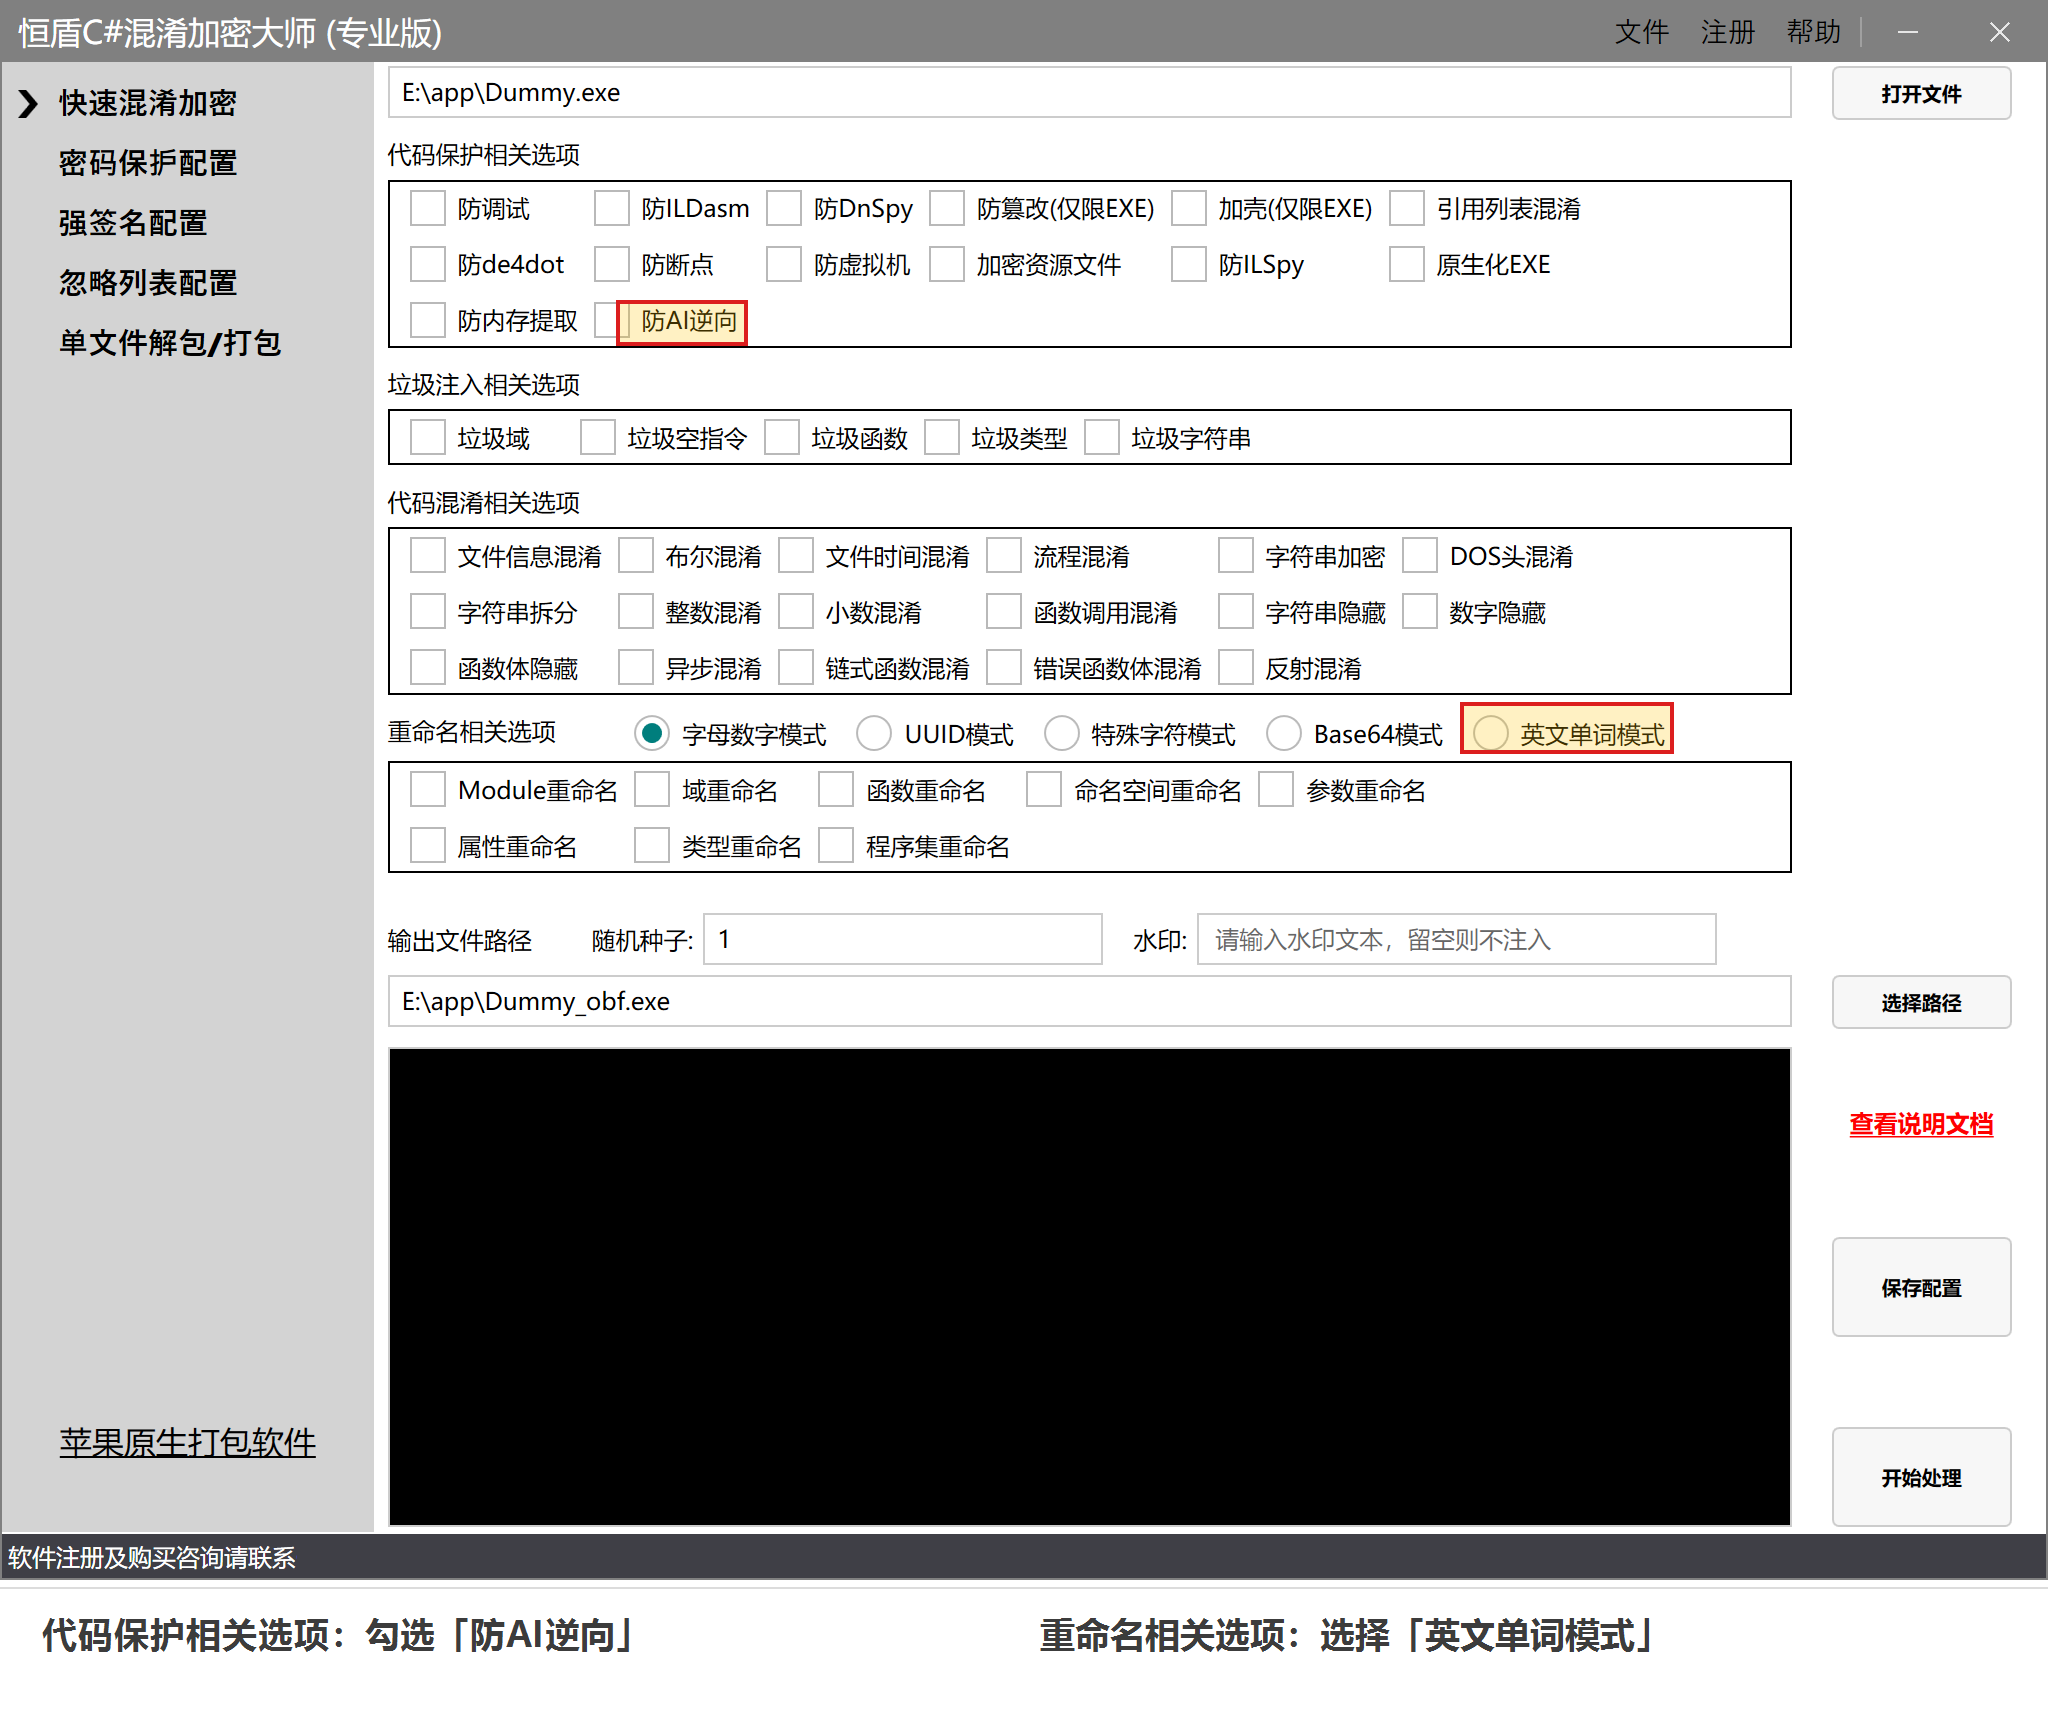
勾选“防AI逆向”后,软件会向程序内部注入大量干扰信息:大量无用的内容与真实业务代码混在一起,结构和真实代码看起来并没有明显差别。
对程序本身来说,这些内容不参与业务运行;但对分析过程来说,它们会带来几个很直接的影响:
- 需要看的东西变多了:原本一个不大的程序,可被读取的内容成倍增加。
- AI 的分析容量被占满:AI 一次能处理的内容是有限的,干扰信息先占了位置,真正关键的代码反而被挤到后面,甚至直接被截断——也就是常说的“上下文溢出”。
- 结论更容易跑偏:当大部分内容都是干扰项时,AI 更容易把无关代码当成重点,给出的判断也需要人反复验证。
- 时间成本被拉长:分析者不得不把程序切成很多段,反复提问、反复比对,才能拼出一个大致完整的认识。
简单说,这项功能不是让程序“不能被分析”,而是让分析这件事从“一次提问”变成“一场消耗战”。
单独用可以,但配合英文单词模式效果更明显
防AI逆向处理的是“读不完”的问题,而重命名处理的是“找不到”的问题。两者叠加,才覆盖了 AI 分析的两个关键环节。
在重命名相关选项中,提供字母数字、UUID、特殊字符、Base64 和英文单词等多种模式。多数人的直觉是“名字越乱越好”,但从对抗 AI 检索的角度看,结论恰好相反。
分析者让 AI 定位关键代码,最常用的手段是检索:
- 搜索
license、auth、verify、trial、expire、serial这类关键词; - 观察函数名、类型名是否“像业务代码”;
- 顺着调用关系找入口。
字母数字、UUID、Base64 这类命名,一眼就能看出“这是被混淆过的”,AI 反而会意识到需要换一种策略,比如转而根据字符串、调用链、结构特征去推断。
英文单词模式不一样。它会把类型、函数、字段、参数重命名成普通的英文单词组合,看上去和正常项目的命名没有区别:
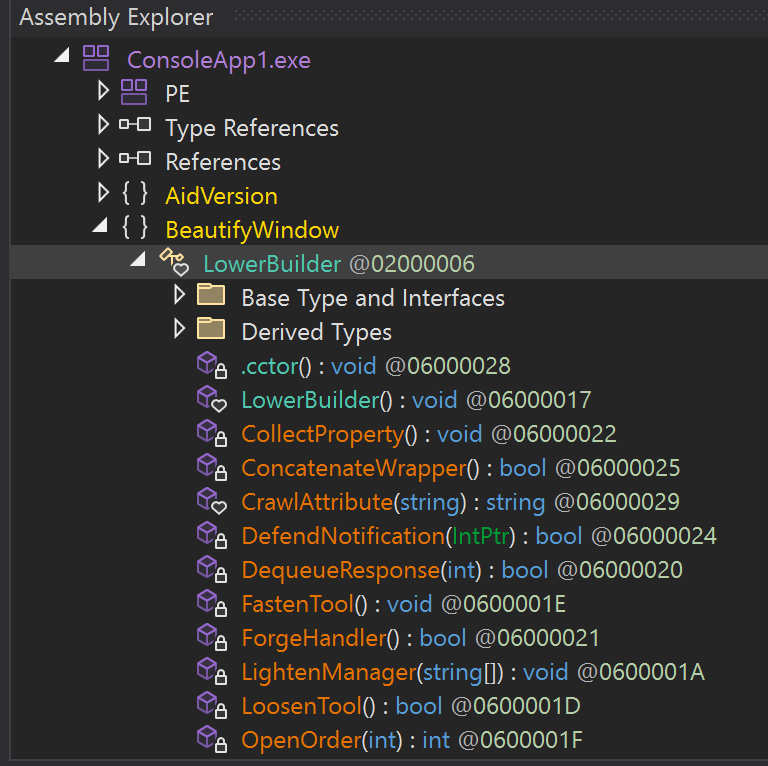
授权校验、试用期判断、注册码验证这些关键位置,会混在一大堆“看起来同样正常”的名字里。分析者用关键词搜索,要么搜不到,要么命中太多;交给 AI 判断,AI 也很难仅凭命名分出主次。
再叠加防AI逆向带来的大量干扰信息,检索出来的结果真假难辨,分析者往往要在几十个可疑点之间来回验证——而真正的授权逻辑,可能就在其中某个不起眼的位置。
一句话概括这套组合:防AI逆向让 AI 读不完,英文单词模式让 AI 搜不到。
推荐的组合方式
不同项目不必套用同一份配置,下面的组合可以作为起点:
| 项目类型 | 建议组合 |
|---|---|
| 带授权/注册的商业软件 | 防AI逆向 + 英文单词模式 + 字符串加密 + 流程混淆 |
| 被其他程序调用的 DLL 组件 | 防AI逆向 + 函数重命名 + 类型重命名 + 函数体隐藏 |
| Unity 游戏程序 | 防AI逆向 + 英文单词模式 + 字符串加密 + 加密资源文件 |
| 企业内部工具 | 防AI逆向 + 垃圾函数 + 垃圾类型 |
这里的原则是“够用就好”。防AI逆向本身会增加程序体积和处理时间,重命名范围越大,越需要提前确认项目里没有依赖名称的反射、序列化或第三方框架调用。
上手步骤
- 打开恒盾C#混淆加密大师,选择需要处理的 DLL 或 EXE 文件。
- 在“代码保护相关选项”中勾选防AI逆向。
- 在“重命名相关选项”中选择英文单词模式,并按需勾选函数重命名、类型重命名、域重命名、参数重命名。
- 视项目情况叠加字符串加密、流程混淆等选项。
- 设置输出路径,点击“开始处理”。
- 在干净的测试环境中验证启动、登录、授权、更新、读写等核心功能。
使用时需要注意
- 先小范围验证:第一次启用时,建议只处理一个待发布的版本,确认功能正常后再固定配置。
- 保护按名称查找的代码:反射、序列化、插件加载、ORM 映射等依赖名称的位置,建议加入忽略列表,避免重命名后找不到入口。
- 运行时保护分开测试:防调试、防虚拟机、防断点这类选项会主动终止程序,建议与防AI逆向分批启用,便于定位问题。
- 不要全勾:选项越多,兼容性风险和处理时间越高,按项目实际需求选择即可。
- 它不替代服务端校验:客户端保护提高的是分析成本,真正的授权判定仍应放在服务端。
常见问题
勾选后程序会变慢吗?
干扰信息本身不参与业务逻辑,主要影响是程序体积和处理时间增加。对启动速度敏感的程序,建议实测后再发布。
只勾防AI逆向够不够?
可以单独使用,但它的作用是“稀释”,配合英文单词模式才能在“检索”这一层也形成阻碍。
用了之后是不是就无法被分析了?
不是。它提高的是分析的时间成本和判断难度,不提供绝对安全。真正重要的授权逻辑,仍应结合服务端验证、防篡改和持续更新。
总结
AI 让 C# 程序的分析门槛明显下降,也让传统混淆的“让人看不懂”变得没那么够用。
防AI逆向的思路很朴素:既然分析者靠 AI 快速读代码,那就让程序里充满大量干扰信息,让 AI 读不完、读不准;再用英文单词模式抹掉命名中的语义线索,让常规的代码检索找不到关键位置。两者结合,能让授权、注册、核心算法这些位置不再“一搜就到”。
需要体验新版本,可以通过下面的链接获取: